Adam vs SGD: dua cara menuruni bukit yang sama
Optimizer memperbarui parameter model, yaitu angka yang dipelajarinya, untuk menurunkan loss, skor seberapa salah model itu. SGD (stochastic gradient descent) dan Adam sama-sama melangkah berlawanan arah dengan gradient, yaitu kemiringan loss, tetapi ukuran langkahnya ditentukan dengan cara berbeda.
- Setiap oval menghubungkan titik dengan loss yang sama, 0.1·p₁² + 10·p₂², dengan p₁ dan p₂ pada sumbu param 1 dan param 2, serta titik minimum di lingkaran hijau. Loss melengkung 100 kali lebih tajam ke arah param 2 daripada ke arah param 1. Keduanya mulai dari (2.5, 1.5) dengan noise yang sama pada setiap gradient, untuk meniru mini-batch, sampel acak dari data training. Satu percobaan berhenti ketika sebuah langkah mendarat di target, yaitu loss di bawah 0,02, atau setelah 40 langkah.
- SGD menggeser setiap parameter sebesar learning rate α dikali gradient-nya. Pada jalur merah putus-putus, α = 0.08. Gradient ke arah param 2 adalah 20·p₂, jadi kalau noise diabaikan, setiap langkah mengalikan p₂ dengan 1 − 0.08 × 20 = −0.6 dan membalik tandanya. Inilah zigzag itu. Param 1 hanya menyusut 1,6% per langkah dan, dengan noise, berakhir di 0,84, dengan loss 0,071.
- Adam merata-ratakan gradient terbaru tiap parameter, yang disebut momentum, dan juga kuadratnya. Membagi yang pertama dengan akar yang kedua membuat setiap parameter bergerak paling jauh sekitar α per langkah, securam apa pun arahnya. Jalur oranye menyapu α dari 0,05 sampai 0,30. Pada 0,05 langkahnya terlalu pendek: loss 0,22, lebih buruk daripada SGD. Mulai sekitar 0,15, momentum, yang mempertahankan 90% nilai lamanya setiap langkah, selalu membawa Adam melewati titik minimum. Satu percobaan hanya selesai kalau ada langkah yang mendarat di dalam target saat melintas. Jadi, 0,18 sampai 0,20 kadang kena kadang meleset, dan 0,30 berakhir di param 1 = −1.64, dengan loss 0,40.
Intinya
Penskalaan per parameter membantu ketika sebagian arah jauh lebih curam daripada yang lain. Namun di sini, hasilnya berbalik karena perubahan kecil pada α dan bergantung pada aturan berhenti, jadi setel α dan nilai setiap percobaan dari keseluruhan kurva loss. SGD dengan momentum masih umum dalam klasifikasi gambar, dan di sana ia bisa mengalahkan Adam pada data baru.
Optimizer
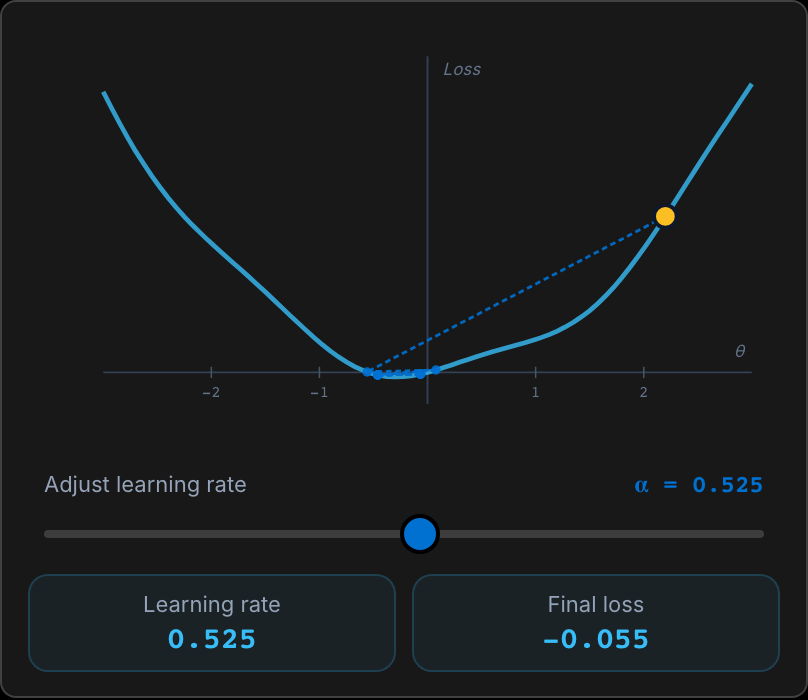
Di langkah 4, geser learning rate (α) dan lihat jalur Adam kurang jauh, mencapai target, lalu kebablasan.
Buka penjelasan interaktif