Bites: satu ide ML, satu gambar, dua menit

Perbandingan
bf16 vs fp16: jangkauan atau ketelitian dalam 16 bit yang sama
2 menit baca
request 1–4request 5–8, antreslot menganggur
Perbandingan
Continuous vs static batching: kenapa server LLM mengisi ulang slot di tiap langkah
2 menit baca

Perbandingan
MoE vs dense: tambah expert, bukan komputasi per token
2 menit baca
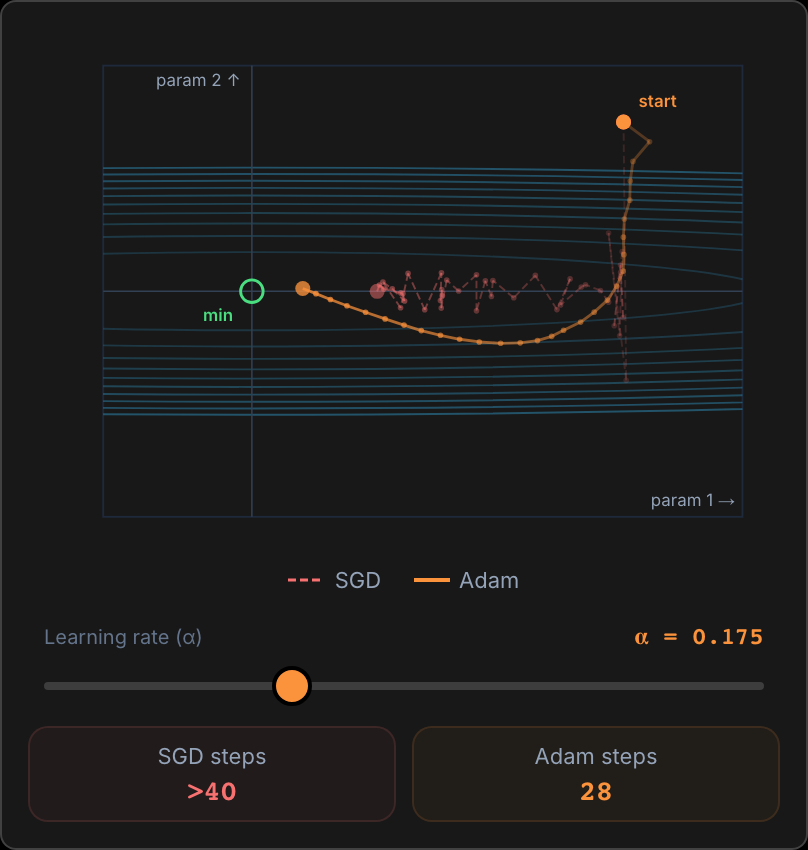
Perbandingan
Adam vs SGD: dua cara menuruni bukit yang sama
2 menit baca
titik trainingsatu pohon (stump)gabungan 20 pohon
Perbandingan
Bagging vs boosting: banyak pohon berdampingan atau berurutan
2 menit baca
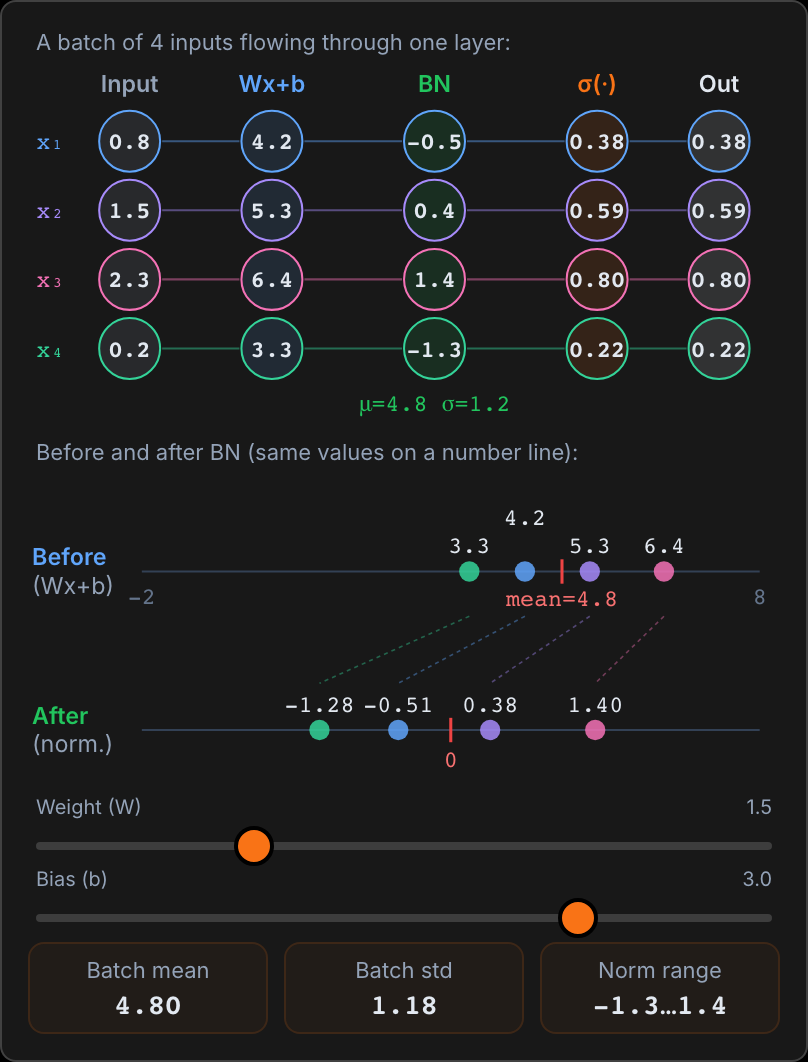
Bahasa sederhana
Batch normalization dengan bahasa sederhana
2 menit baca
satu model (anak panah)lemparan rata-ratajawaban benar
Perbandingan
Bias vs variance: dilihat dari papan dart
2 menit baca
rentang jawabanchunk dengan bagian jawaban terbanyak
Perbandingan
Ukuran chunk: terlalu kecil vs terlalu besar
2 menit baca
| dari A ke | jarak | cosine | jarak pada panjang 1 |
|---|---|---|---|
| B | 2.06 | 1.000 | 0.00 |
| C | 1.80 | 0.901 | 0.45 |
Kotak: vector yang lebih dekat menurut tiap ukuran. Titik bercincin: tiap vector dibagi panjangnya.
Perbandingan
Cosine vs Euclidean: kenapa embedding membandingkan sudut
2 menit baca
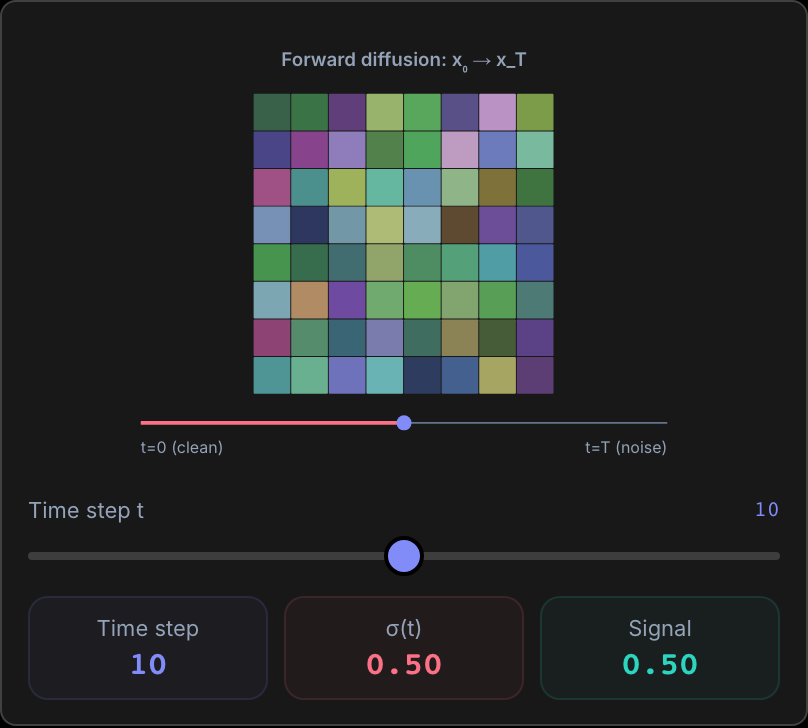
Bahasa sederhana
Diffusion model dengan bahasa sederhana: tambahkan noise, belajar menghapusnya
2 menit baca
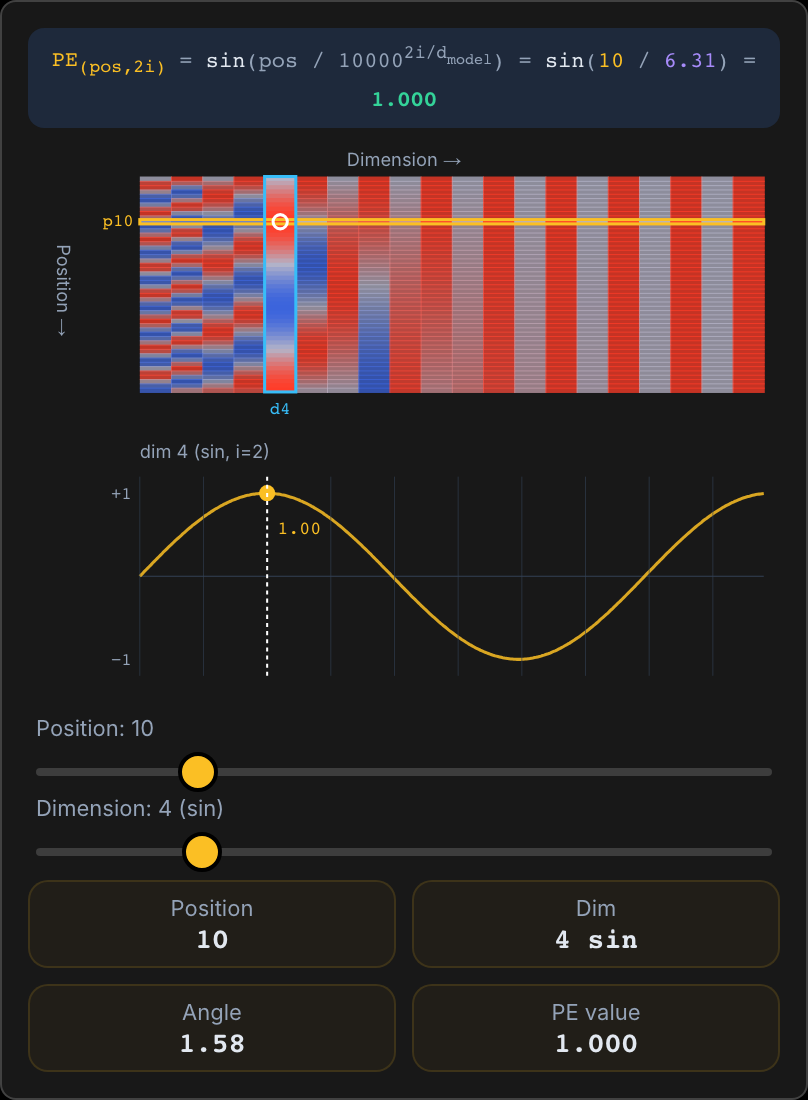
Bahasa sederhana
Cara transformer mengenali urutan kata, dengan bahasa sederhana
2 menit baca
weight pretrained yang dibekukanmatriks LoRA yang dilatih (diberi garis tepi agar terlihat)
Terapan
Cara LoRA melakukan fine-tuning model 7B dengan melatih 0,4% satu layer
2 menit baca
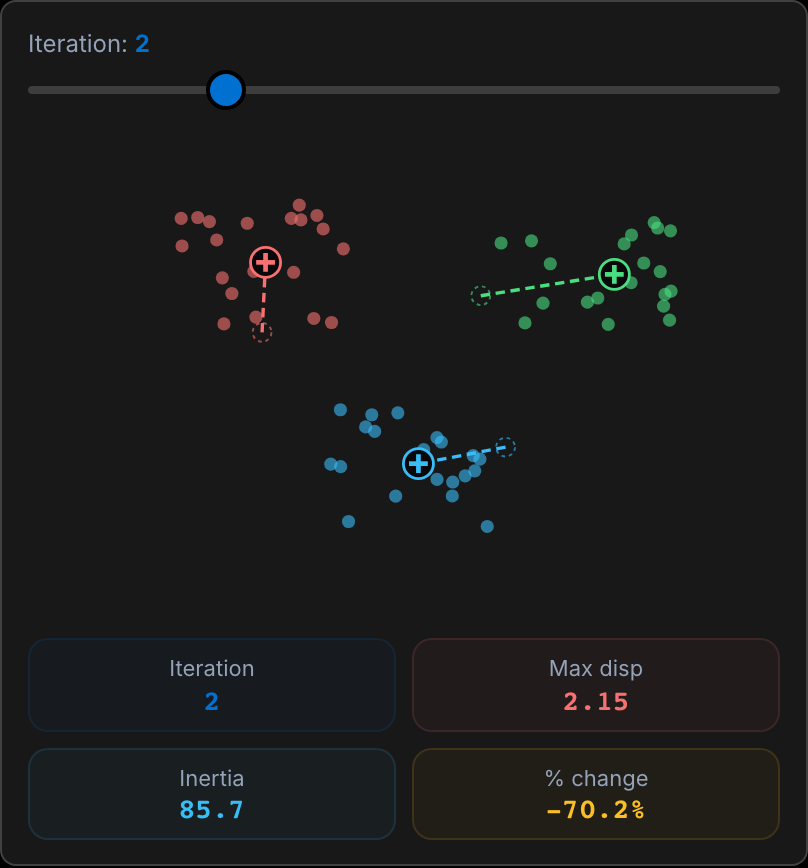
Bahasa sederhana
K-means dengan bahasa sederhana: tebak, geser, ulangi
2 menit baca
kontur lossweight yang diizinkantitik berhenti
Perbandingan
L1 vs L2: kenapa hanya satu yang membuat weight tepat nol
2 menit baca
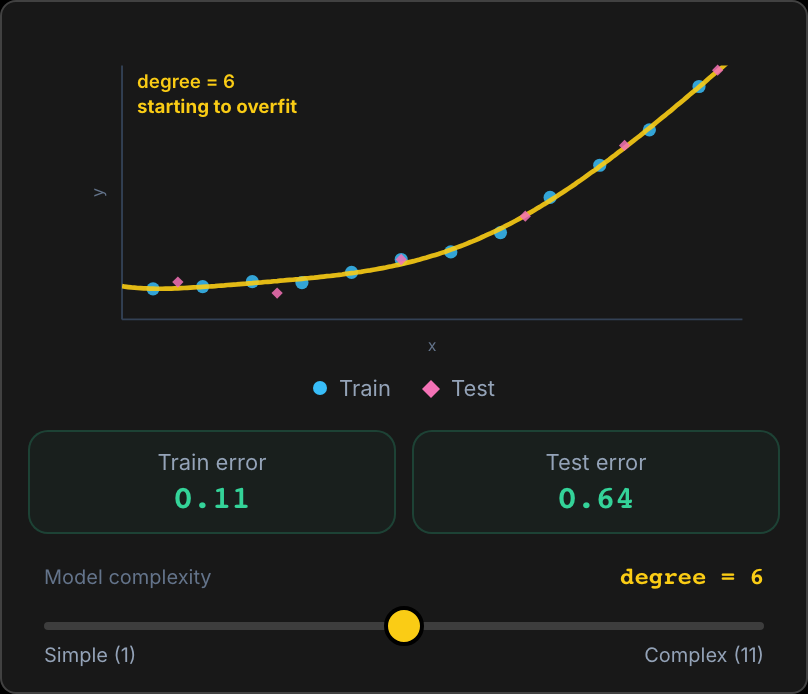
Dalam 1 gambar
Overfitting dalam 1 gambar
2 menit baca
email normal (700)spam (300)false positivefalse negative
Perbandingan
Precision vs recall: satu threshold, dua jenis kesalahan
2 menit baca
retrieval: embed, search, rerankgeneration: prefill, decode
Dalam 1 gambar
Latency RAG dalam 1 gambar
2 menit baca
tempat pengetahuan baru masukaliran data
Perbandingan
RAG vs fine-tuning: mencarinya atau mempelajarinya
2 menit baca
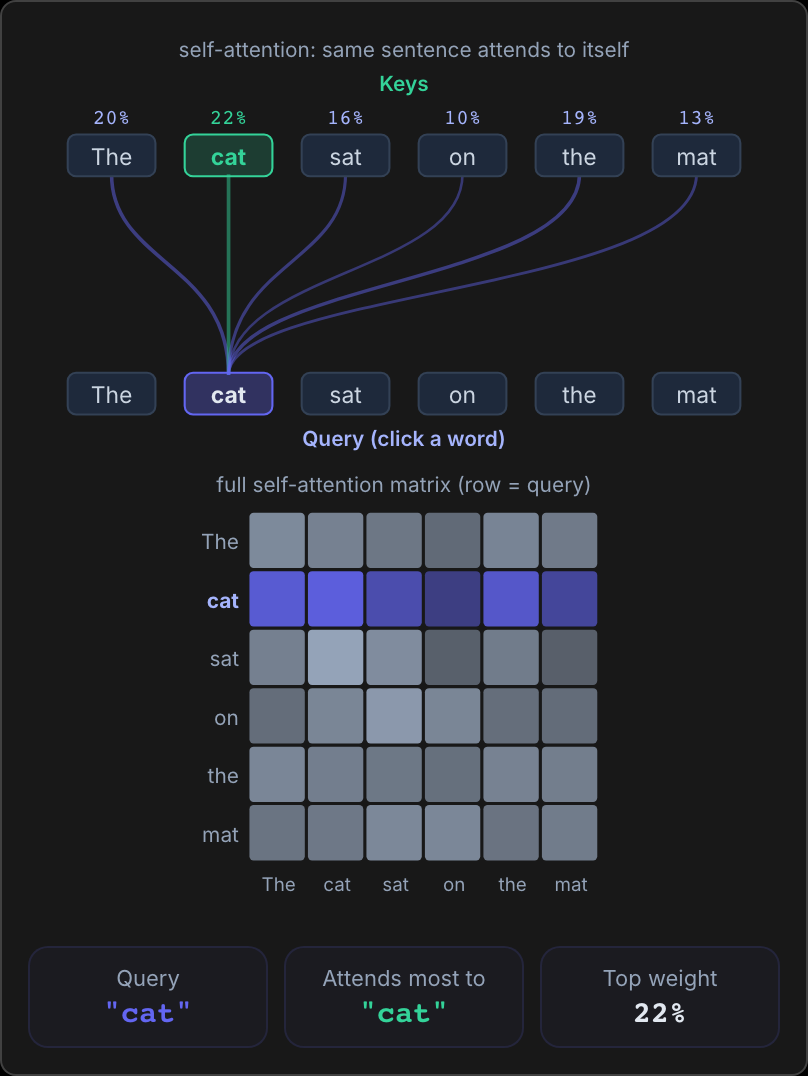
Dalam 1 gambar
Self-attention dalam 1 gambar: setiap kata melihat setiap kata
2 menit baca
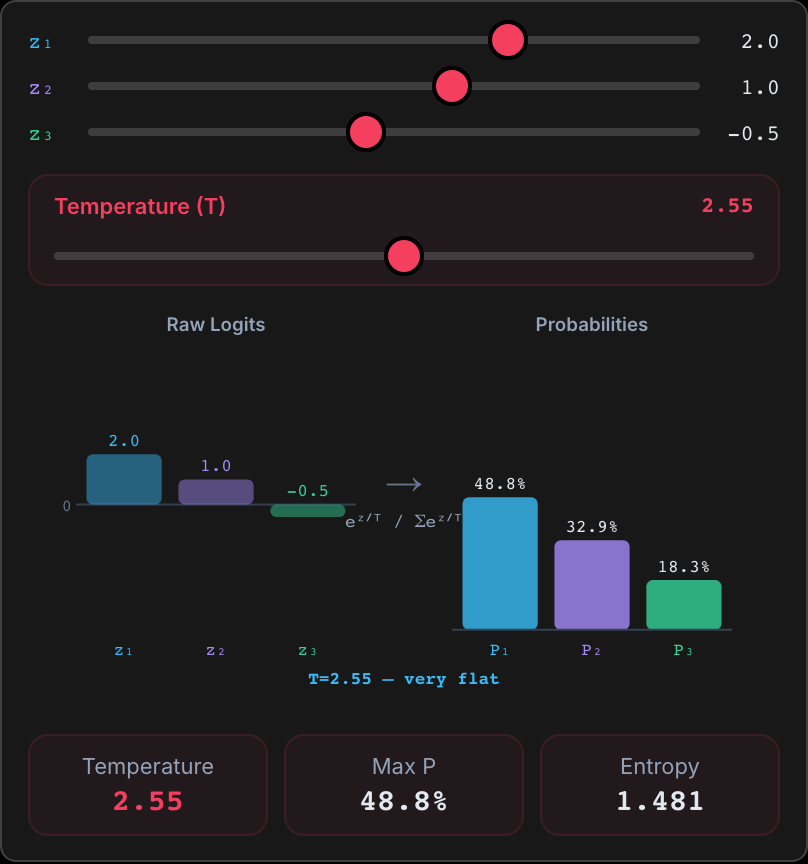
Dalam 1 gambar
Temperature dalam 1 gambar: dari yakin ke menyebar
2 menit baca
Nilai dalam %. Garis putih menandai panjang saat T = 1; kotak putus-putus menandai token yang dipotong.
Perbandingan
Temperature vs top-p: membentuk ulang semua batang atau memotong ekornya
2 menit baca
Dalam 1 gambar
Corong rekomendasi dalam 1 gambar
2 menit baca
layer pretrained yang dibekukanhead baru, dilatih (diberi garis tepi agar terlihat)
Tinggi blok hanya skematis. Head lama 1.000 kelas (2.049.000 weight) dibuang.
Terapan
Transfer learning: bekukan 99,9% model, latih layer terakhir yang baru
2 menit baca
TN: normal, lolosFP: alarm palsuFN: penipuan terlewatTP: penipuan tertangkap
10.000 transaksi, 100 di antaranya penipuan. Baris: kelas sebenarnya. Kolom: keputusan model.
Terapan
Kenapa akurasi 99% bisa berarti model tak berguna
2 menit baca
eksplorasi 10%
click rate ronde 40 42.1%
impression Gini 0.89
tanpa eksplorasi
click rate ronde 40 46.2%
impression Gini 0.97
Terapan
Kenapa feed terjebak pada item populer
2 menit baca
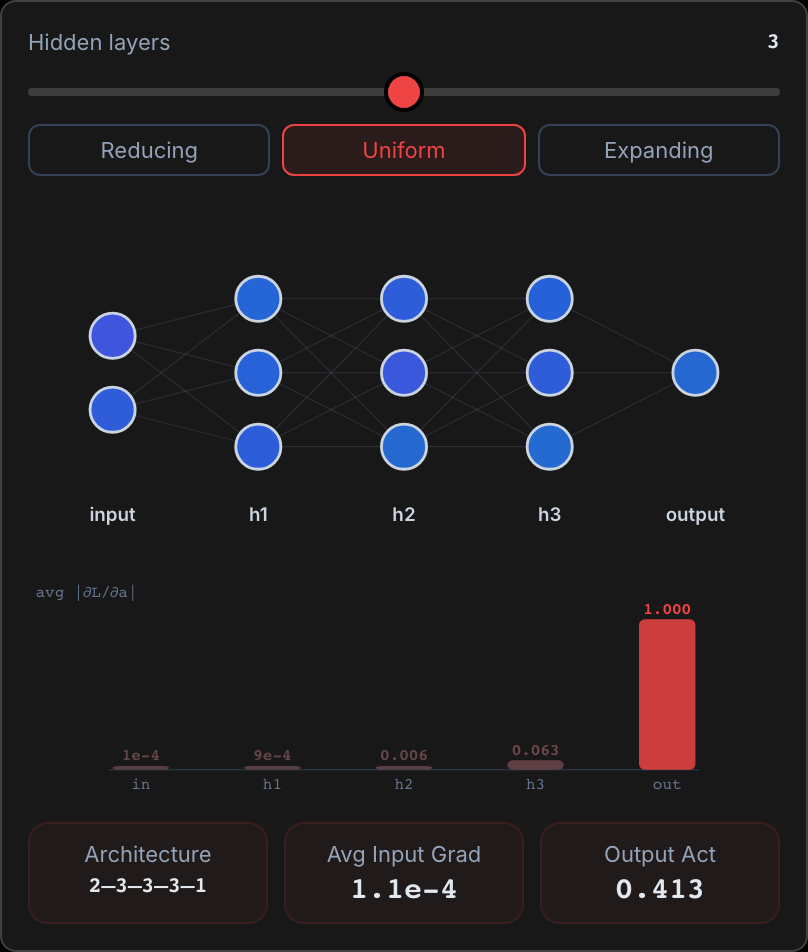
Dalam 1 gambar
Kenapa gradient menghilang di network dalam, dalam 1 gambar
2 menit baca
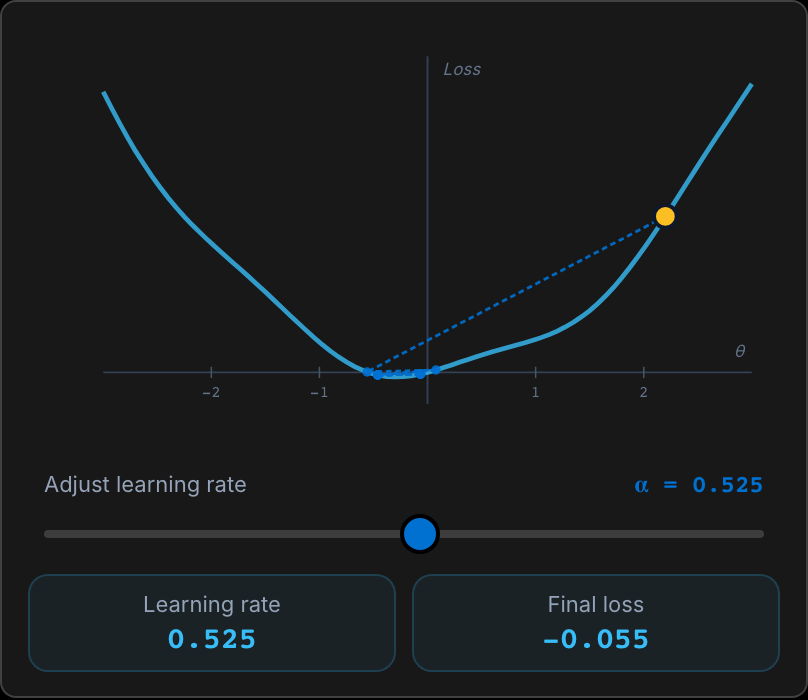
Dalam 1 gambar
Kenapa loss memantul saat learning rate terlalu tinggi
2 menit baca