Batch normalization dengan bahasa sederhana
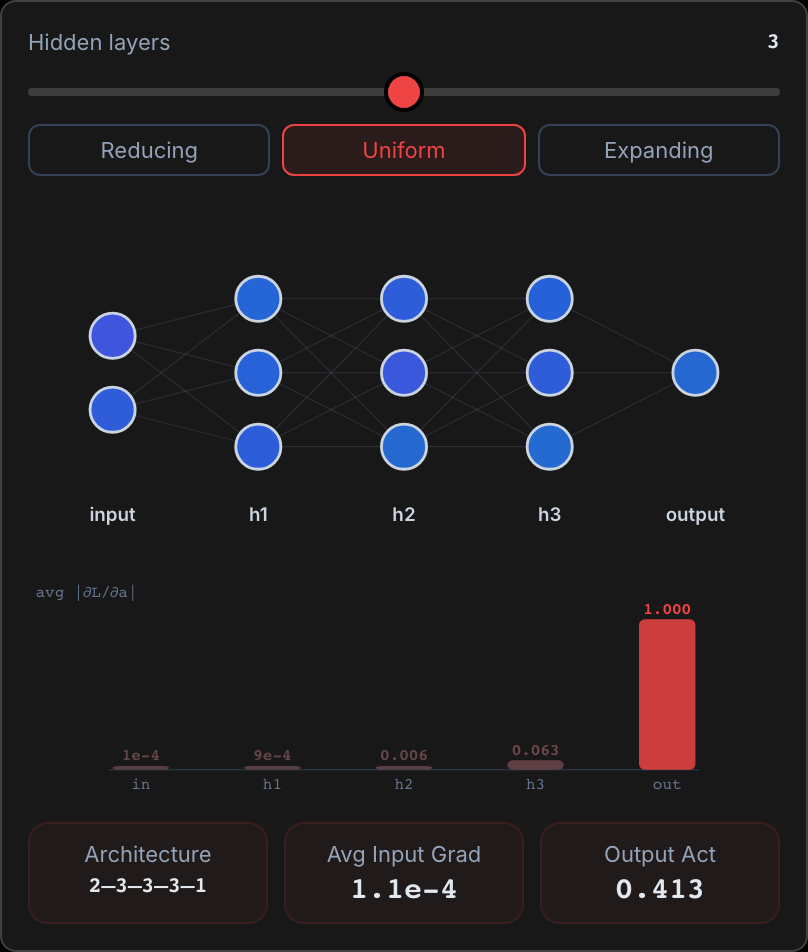
Neural network meneruskan angka dari layer ke layer, dan training terus mengubah weight, yaitu angka yang dipakai tiap layer untuk mengalikan input-nya. Nilai yang sampai ke layer berikutnya bisa bergeser jauh dari nol, ke area tempat fungsi berbentuk S menjadi datar dan proses belajar macet. Batch normalization, atau BN, mengatur ulang nilai itu untuk setiap batch, kelompok kecil contoh yang dilatih sekaligus.
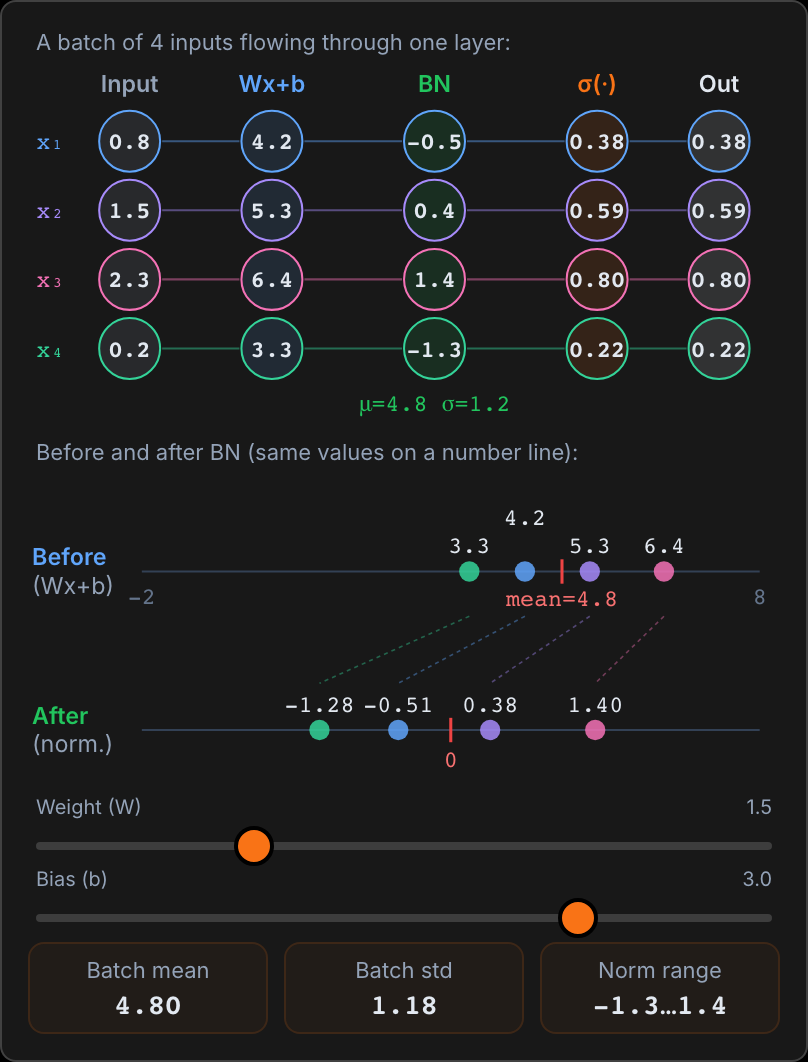
- Gambar ini mengikuti satu batch berisi 4 input, x₁ sampai x₄, melewati satu layer. Pertama, layer menghitung Wx + b: setiap input dikali weight W, lalu ditambah bias b, angka yang dijumlahkan ke setiap nilai. Dengan W = 1.5 dan b = 3.0, input 0,8, 1,5, 2,3, dan 0,2 menjadi 4,2, 5,25, 6,45, dan 3,3, yang ditampilkan setelah dibulatkan. Keempatnya berada jauh di kanan nol.
- BN lalu mengukur batch itu: rata-rata keempat nilai adalah 4,80, dan simpangan baku, jarak khas dari rata-rata itu, adalah 1,18. Keduanya tampil dibulatkan sebagai μ dan σ di bawah kolom BN. BN mengurangi setiap nilai dengan rata-rata lalu membaginya dengan simpangan baku. Garis After menunjukkan hasilnya: −1,28, −0,51, 0,38, dan 1,40, berpusat di 0 dengan simpangan baku 1. Titik-titiknya mempertahankan urutan dan jarak relatifnya.
- Kolom berikutnya, σ(·), adalah sigmoid, fungsi berbentuk S dengan output antara 0 dan 1. Setelah BN, fungsi ini menerima nilai di dekat bagian tengahnya yang curam dan menghasilkan 0,22 sampai 0,80. Kalau menerima nilai mentah, output-nya 0,96 sampai 1,00, di puncaknya yang datar, tempat kemiringannya mendekati 0. Kemiringan kecil berarti gradient kecil, padahal gradient adalah sinyal yang memberi tahu tiap weight cara berubah. Mengubah W atau b tidak menggeser nilai After: BN menghapus setiap regangan atau pergeseran.
Intinya
BN versi lengkap lalu menerapkan skala γ (gamma) dan pergeseran β (beta) yang dipelajari, sehingga network bisa membatalkan pengaturan ulang itu kalau memang membantu. Saat pengujian, BN memakai rata-rata berjalan yang disimpan selama training, bukan statistik batch. Batch yang sangat kecil membuat statistik itu berisik, dan kebanyakan transformer memakai layer normalization, yang merata-ratakan di dalam tiap contoh.
Batch Normalization
Di langkah yang menunjukkan BN sedang bekerja, geser weight (W) dan bias (b), lalu lihat garis After tetap di tempatnya.
Buka penjelasan interaktif