Cara transformer mengenali urutan kata, dengan bahasa sederhana
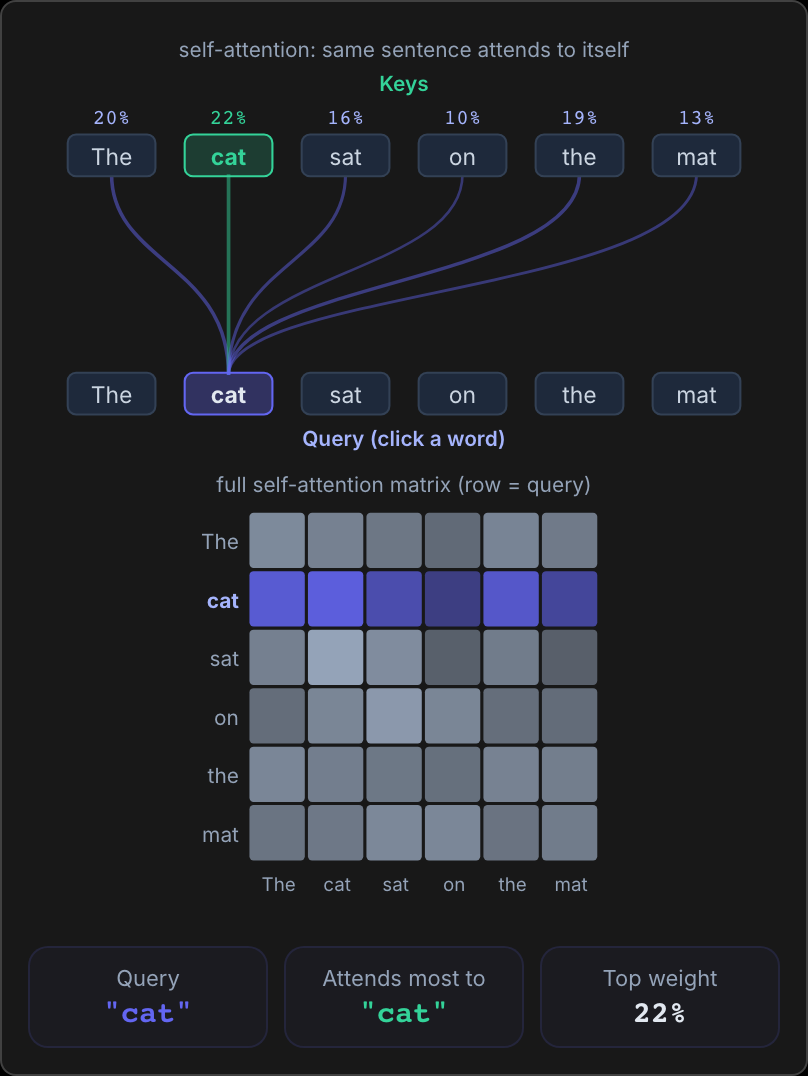
Transformer, rancangan model di balik model bahasa besar, membaca semua kata dalam kalimat sekaligus. Langkah attention-nya, tempat setiap kata mengumpulkan konteks dari kata lain, membandingkan kata hanya menurut makna, jadi ia tidak bisa membedakan "dog bites man" dari "man bites dog". Positional encoding mengatasi ini dengan menambahkan tag posisi ke setiap kata.
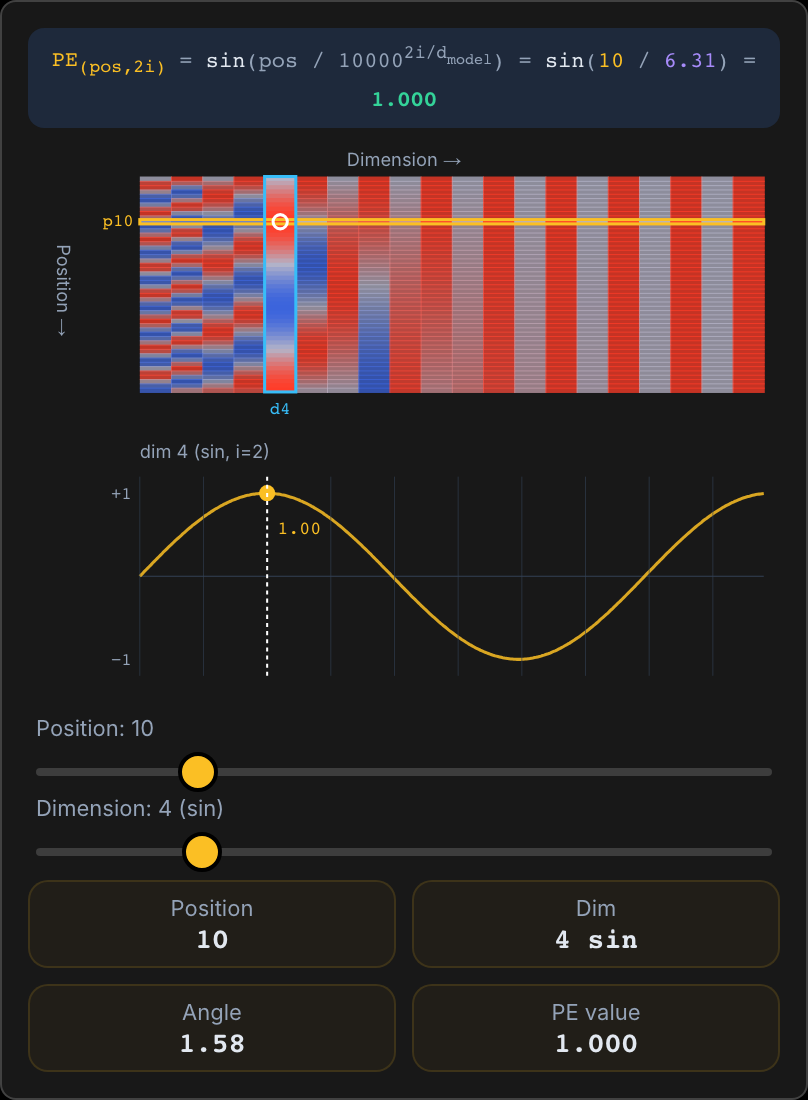
- Setiap kata masuk sebagai embedding, deretan angka yang mewakilinya, dan tag-nya adalah deretan sepanjang itu yang ditambahkan padanya. Di heatmap, setiap baris adalah tag untuk satu posisi, 0 sampai 49 dari atas, dan setiap kolom adalah satu dimensi, satu tempat dalam deretan itu. Merah berarti +1, biru berarti −1, dan abu-abu pucat berarti 0.
- Setiap kolom mengikuti satu gelombang: PE(pos, 2i) = sin(pos / 10000^(2i/d)) untuk kolom genap, dengan cos menggantikan sin untuk kolom 2i + 1. Di sini pos adalah posisi, 2i adalah nomor kolom, d = 20 adalah jumlah dimensi, dan ^ berarti "pangkat". Kurva di bawah heatmap adalah kolom 4, sin(pos / 6.31), yang memuncak di 1,000 pada posisi 10. Kolom 0 dan 1 berulang setiap 6,3 posisi, jadi warnanya berganti kira-kira setiap tiga baris. Setiap pasangan kolom di sebelah kanannya sekitar 2,5 kali lebih lambat.
- Warna satu baris adalah sidik jari posisi itu. Satu gelombang cepat tidak cukup: pada kolom 0 dan 1, posisi 2 dan 46 terbaca 0,91 dan −0,42 dibandingkan 0,90 dan −0,43. Kolom 2 membedakan keduanya, 0,71 dibandingkan −0,51, seperti jarum jam di samping jarum menit. Gelombang paling lambat membentang ribuan posisi, jadi sepanjang 50 baris ini sinus tetap dekat 0 (abu-abu pucat) dan kosinus dekat 1 (merah), yang membentuk garis lebar di sebelah kanan. Pada dokumen panjang, gelombang ini memisahkan posisi yang berjauhan.
Intinya
Tag ini tetap, tidak ada yang dipelajari, dan Transformer asli memakai 512 dimensi. BERT dan GPT-2 mempelajari tabel tag sebagai gantinya, dengan 512 dan 1.024 baris. Banyak model bahasa yang lebih baru memakai rotary position embedding (RoPE), yang menerapkan gelombang serupa di dalam langkah attention.
Positional Encoding
Di langkah tentang sinusoidal encoding, geser posisi dan dimensi, lalu lihat baris bergaris tepi dan gelombang di bawahnya berubah.
Buka penjelasan interaktif