Self-attention dalam 1 gambar: setiap kata melihat setiap kata
Self-attention adalah langkah di dalam transformer, rancangan model di balik model bahasa besar, tempat setiap kata mengumpulkan konteks dari bagian lain kalimat. Setiap kata memberi weight ke setiap kata, termasuk dirinya, dan weight yang diberikan satu kata berjumlah 1.
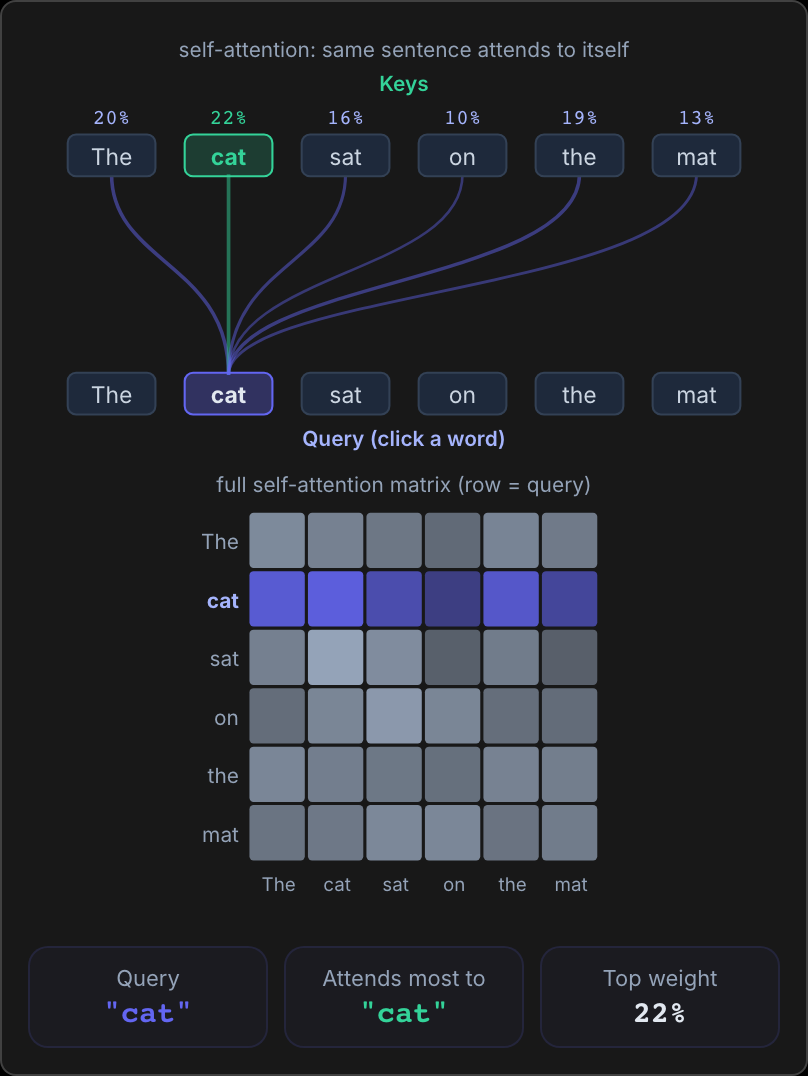
- Gambar ini memakai kalimat "The cat sat on the mat". Query, yaitu kata yang sedang melihat, adalah "cat" di baris bawah. Garis berjalan darinya ke keenam kata di baris atas, yang disebut key, dan setiap persentase adalah weight yang diberikan "cat" ke kata itu. Garis hijau menuju "cat" sendiri dengan 22%, lalu "The" dengan 20% dan "the" dengan 19%, sampai "on" dengan 10%. Keenam weight berjumlah 100%.
- Embedding setiap kata, deretan angka yang mewakilinya, menjadi tiga deretan yang disebut vector: query, key, dan value, isi yang diteruskan sebuah kata. Skor satu pasangan adalah dot product vector query satu kata dan vector key kata lainnya (kalikan angka yang bersesuaian, lalu jumlahkan), dibagi √3 karena tiap vector berisi 3 angka. Softmax mengubah skor menjadi weight yang berjumlah 1, dan output untuk "cat" adalah rata-rata berbobot dari keenam value.
- Kisi ini mengulangi hal itu untuk setiap kata: tiap baris adalah satu query, tiap kolom satu key, dan sel yang lebih terang berarti weight lebih besar. Baris ungu adalah baris "cat" yang digambar di atas. Sel abu-abu paling terang adalah "sat" yang melihat "cat", dengan 24%. Vector contoh berisi 3 angka ini menghasilkan weight yang cukup datar, dari 10% sampai 24%. Model yang sudah dilatih sering memakai 64 atau 128 angka per attention head, satu dari beberapa salinan langkah ini yang berjalan berdampingan, dan menghasilkan pola yang jauh lebih tajam.
Intinya
Self-attention memungkinkan setiap kata memakai seluruh kalimat dalam satu langkah, jadi model bisa menghubungkan kata ganti dengan kata bendanya sejauh apa pun jaraknya. Biayanya ada di kisi: satu sel per pasangan kata, jadi menggandakan jumlah kata membuat jumlah skor menjadi empat kali lipat. Model bahasa yang menulis teks juga menyembunyikan semua sel di atas diagonal, sehingga tidak ada kata yang melihat kata sesudahnya.
Cara Kerja Self-Attention
Klik setiap kata di baris query dan lihat garis attention dan baris kisinya berubah.
Buka penjelasan interaktif