Temperature vs top-p: membentuk ulang semua batang atau memotong ekornya
Model bahasa menulis satu token demi satu token, dengan token berupa kata atau bagian kata. Di setiap langkah, ia memberi probabilitas ke setiap token kandidat, lalu mengambil satu secara acak. Temperature dan top-p sama-sama mengubah probabilitas itu sebelum pengambilan, dengan cara berbeda.
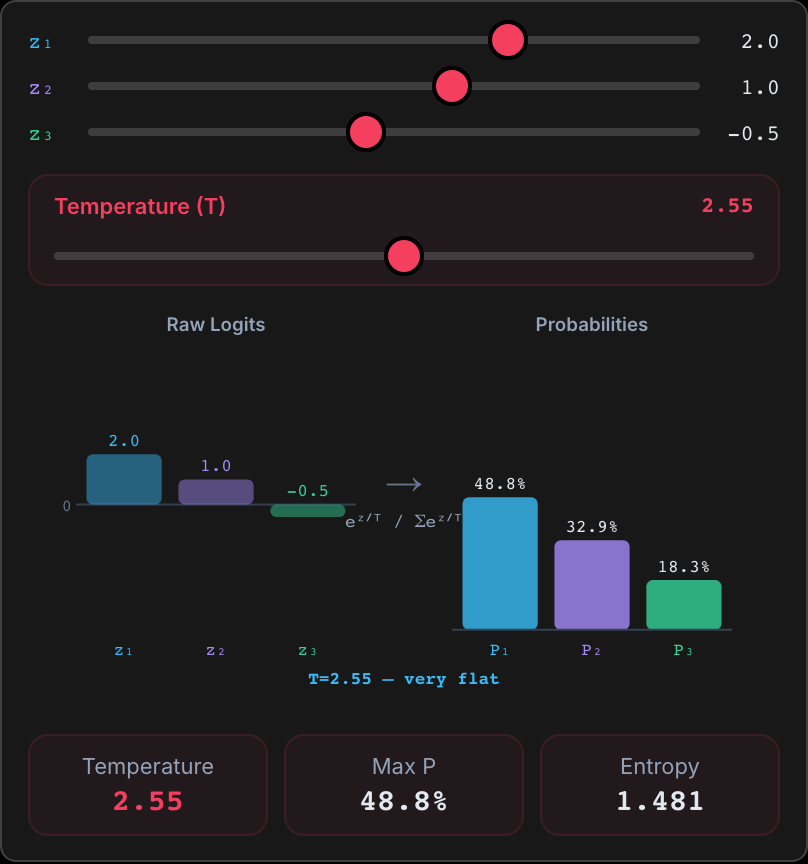
- Batangnya berasal dari prompt cerita di penjelasan interaktifnya, "Once upon a time, there was a ___", dengan sepuluh token kandidat. Model memberi masing-masing skor mentah yang disebut logit, dari 4,4 untuk "little" sampai 2,3 untuk "boy". Softmax mengubah logit menjadi probabilitas yang berjumlah 1: ia memangkatkan e dengan tiap logit lalu membaginya dengan totalnya. Temperature T adalah angka yang membagi setiap logit sebelum softmax. Pada T = 1 tidak ada yang berubah, jadi "little" mendapat 25,6% dan "boy" 3,1%.
- Pada T = 0.5, jarak antar-logit menjadi dua kali lipat, jadi "little" naik ke 44,2% dan "boy" turun ke 0,7%. Setiap batang bergerak, dan tidak ada yang jatuh ke nol. Peringkatnya tidak pernah berubah. T di atas 1 melakukan kebalikannya dan meratakan batang menuju sama tinggi.
- Top-p, yang juga disebut nucleus sampling, membiarkan bentuknya dan memotong ekornya. Ia mengurutkan token dari yang paling mungkin ke yang paling tidak mungkin dan terus menambahkannya sampai totalnya mencapai p. Dengan p = 0.9, tujuh token pertama mencakup 88,8% dan yang kedelapan, "dragon", membawa total ke 93,0%, jadi delapan tersisa. "princess" dan "boy" terpotong, dan batang yang tersisa dibagi 0,930 supaya berjumlah 1 lagi: "little" menjadi 27,5%. Pada prompt faktual di penjelasan interaktifnya, "Paris" sendiri punya 96,2%, jadi p yang sama hanya menyimpan satu token.
Intinya
Temperature mengatur seberapa kuat model mengutamakan pilihan teratasnya. Top-p mengatur berapa banyak pilihan yang tetap dipertimbangkan, dan menyesuaikan jumlah itu di tiap langkah. Turunkan temperature untuk teks yang fokus dan bisa diulang, seperti kode atau ekstraksi data. Pakai top-p, sering 0,9 sampai 0,95, untuk menjaga keragaman sambil membuang ekor panjang token yang tidak mungkin. Sebagian penyedia API menyarankan mengatur salah satunya, bukan keduanya.
Sampling: Temperature, Top-k, dan Top-p
Di langkah 5, geser p dan ganti prompt untuk melihat nucleus membesar dan mengecil.
Buka penjelasan interaktif