Bias vs variance: dilihat dari papan dart
Bias dan variance adalah dua cara prediksi model bisa salah. Bayangkan melatih model yang sama berkali-kali, setiap kali dengan sampel data baru. Setiap anak panah adalah prediksi satu model untuk input yang sama, dan titik tengah papan adalah jawaban yang benar.
2 menit baca · Lensa ML
- Bias adalah selisih antara prediksi model rata-rata dan nilai sebenarnya: seberapa jauh anak panah rata-rata mendarat dari titik tengah. Variance adalah seberapa banyak model berubah dari satu sampel training ke sampel berikutnya: seberapa lebar anak panah tersebar. Cincin emas menandai setiap lemparan rata-rata. Cincin itu tepat di titik tengah pada baris atas dan bergeser ke samping pada baris bawah, dan garis putus-putus menuju cincin itu adalah bias-nya. Kolom kanan tersebar lebar.
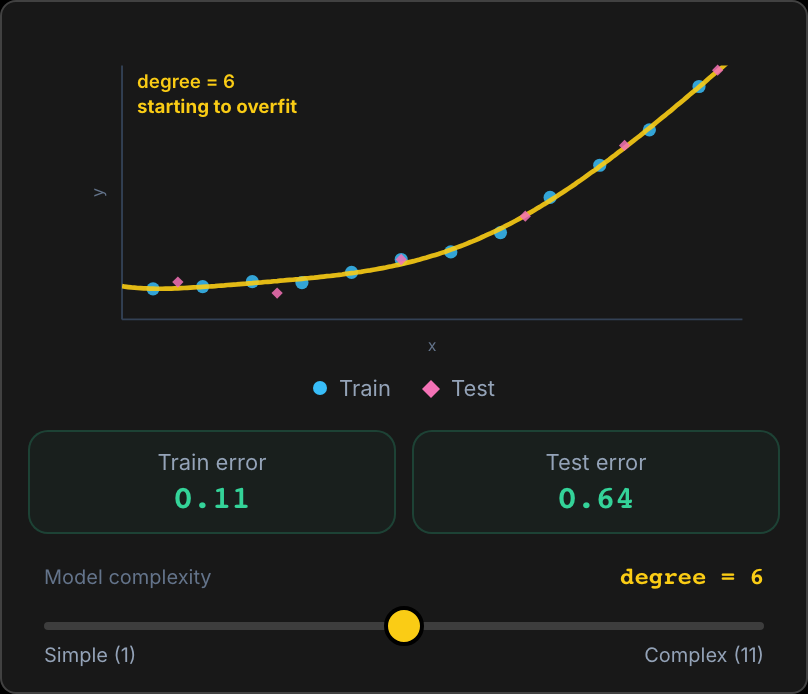
- Training error adalah error model pada data yang dipelajarinya. Test error adalah error-nya pada data baru. Model dengan bias tinggi terlalu sederhana untuk polanya, seperti garis lurus yang dicocokkan ke kurva. Model ini underfit, melewatkan pola: kedua error tinggi dan berdekatan. Model dengan variance tinggi cukup lentur untuk mengejar noise pada sampelnya. Model ini overfit, menghafal noise itu: training error rendah dan test error jauh lebih tinggi. Kalau bias juga tinggi, training error tetap tinggi.
- Kalau error diukur sebagai kuadrat selisih prediksi dan nilai sebenarnya, test error yang diharapkan terbagi tepat menjadi tiga bagian: bias² + variance + noise yang tak bisa dihilangkan. Noise itu adalah keacakan dalam data itu sendiri, batas bawah yang tidak bisa dilewati model apa pun. Model yang lebih kompleks biasanya menukar bias yang lebih rendah dengan variance yang lebih tinggi, jadi test error paling rendah ada di tengah-tengah. Untuk model yang sama, data training yang lebih banyak terutama mengecilkan variance. Papan dart menyembunyikan satu hal: dalam praktik, kamu hanya punya satu anak panah dan tidak pernah melihat yang lain. Sumbu kedua pada anak panah hanya untuk tampilan.
Intinya
Bandingkan training error dengan validation error, yang diukur pada data di luar training. Kalau keduanya tinggi, coba model yang lebih lentur atau variabel input yang lebih banyak. Kalau training error rendah dan validation error jauh lebih tinggi, pangkas variance dengan data yang lebih banyak, regularization (penalti untuk weight yang besar), atau rata-rata dari banyak model.
Pelajari lebih dalam · interaktif
Bias-Variance Tradeoff
Geser derajat polinomial dan lihat hasil pencocokan dari lima sampel baru saling menjauh.
Buka penjelasan interaktif